

هوش مصنوعی Claude و مدلهای جدید Fable 5.1 و Mythos 5.1
آنچه میخوانید
Toggleاگر دنبال این هستی که بدونی هوش مصنوعی Claude چیست، چه فرقی با ChatGPT داره، نسخه رایگانش چطوره، و مدل جدیدی که همه دربارش حرف میزنن یعنی چی — جای درستی اومدی. این مقاله بخشی از راهنمای کامل خانواده Claude 5 ماست و تمرکزش روی دو مدل جدیدیه که Anthropic اول سپتامبر ۲۰۲۶ معرفی کرد: Claude Fable 5.1 و Claude Mythos 5.1.
یه نکته که همون اول کار رو روشن میکنه: این دوتا مدل از نظر وزنها یکیان. فرقشون توی سیاستهای ایمنی و سطح دسترسیه، نه توانایی خام مدل.
پاسخ کوتاه
- Claude دستیار هوش مصنوعی ساخت Anthropicه؛ رایگان (با محدودیت)، Pro، Max و Enterprise داره.
- Fable 5.1 پیشرفتهترین مدل عمومی Anthropicه، برای کدنویسی و کارهای تحقیقاتی طولانی.
- Mythos 5.1 همون مدله با safeguards متفاوت، فقط برای کاربران تأییدشده در حوزه سایبری و علوم زیستی.
- خود Anthropic توصیه میکنه اول از Opus 5 شروع کنی و فقط اگه جواب نداد سراغ Fable 5.1 بری.
- مهمترین ایراد: مصرف توکن بالا — طبق یه تحلیل مستقل، هر تسک تا ۲۰٪ گرونتر از نسل قبل تموم میشه.
هوش مصنوعی Claude
Claude محصول شرکت Anthropicه؛ شرکتی که سال ۲۰۲۱ توسط چند پژوهشگر سابق OpenAI تأسیس شد و محور اصلیاش ایمنی هوش مصنوعیه. Claude متن میفهمه و تولید میکنه، تصویر و سند تحلیل میکنه، کد مینویسه، از ابزار استفاده میکنه و میتونه روی کارهای طولانی تمرکز کنه.
خانواده مدلهای Claude
برای دید کاملتر روی هر نسل، صفحه تحلیل خانواده Claude 5 رو ببین. خلاصه نردبان فعلی:
| رده | مناسب برای | قیمت API (ورودی/خروجی به ازای هر میلیون توکن) |
|---|---|---|
| Haiku 4.5 | سریعترین، کارهای سبک | ۱ / ۵ دلار |
| Sonnet | تعادل سرعت و هوش، چت روزمره | ۲ / ۱۰ دلار |
| Opus 5 | استدلال سنگین — پیشنهاد پیشفرض Anthropic برای اکثر کارها | ۵ / ۲۵ دلار |
| Fable 5.1 | کارهای طولانی، ایجنتی و پژوهشی | ۱۰ / ۵۰ دلار |
Mythos 5.1 را عمداً از این جدول بیرون گذاشتم: Mythos یک ردیف جداگانه در نردبان قیمتی نیست، بلکه پیکربندی safeguards متفاوتی از همون Fable 5.1 است که فقط از طریق برنامههای دسترسی تأییدشده در اختیار قرار میگیرد — نه یک انتخاب عمومی مثل بقیه ردیفهای جدول.
Claude بهتر است یا ChatGPT؟
جواب صادقانه: به کارت بستگی داره. توی کدنویسی و کارهای ایجنتی طولانی، Fable 5.1 توی شاخص Artificial Analysis بالاترین نمره ثبتشده رو گرفته. توی اختصار و خلاصهگویی، خیلی از کاربران مدلهای OpenAI مثل GPT-5.6 رو ترجیح میدن، چون Claude معمولاً پرحرفتره. توی هزینه، مدلهای OpenAI معمولاً ارزونترن. توی بخش نظرات کاربران پایینتر میبینی خیلیها هر دو رو کنار هم استفاده میکنن.

دسترسی، ثبت نام و نسخه رایگان Claude
چگونه در Claude ثبت نام کنیم
سادهترین راه رفتن به claude.ai و ساخت اکانت با ایمیله. اپلیکیشن دسکتاپ (ویندوز و مک) و موبایل (iOS و اندروید) هم از همون سایت رسمی قابل دانلوده.
آیا Claude رایگان است؟
بله، یه پلن رایگان با سقف استفادهای هست که هر پنج ساعت ریست میشه و مقدارش بسته به شلوغی سرور تغییر میکنه. جزئیات دقیق اینکه پلن رایگان دقیقاً به کدوم مدلها دسترسی میده، توی صفحه رسمی قیمتگذاری Anthropic اعلام میشه و ممکنه با گذر زمان تغییر کنه — برای عدد قطعی همون صفحه رو چک کن. چیزی که مستند شده اینه: Fable 5.1 برای همه مشتریان API فعاله؛ این با دسترسی مصرفی در پلن رایگان claude.ai یکی نیست.
محصولات مختلف Claude
- Claude Code — ابزار خط فرمان برای برنامهنویسها.
- Claude API — دسترسی برنامهنویسی برای ساخت اپلیکیشن.
- Claude for Excel — دستیار داخل اکسل.
- Claude Security — اسکن کدبیس برای آسیبپذیری که پیشنهاد پچ میده و برای بازبینی انسانی میفرسته، نه اینکه امنیت رو خودکار تضمین کنه. الان با Mythos 5.1 کار میکنه.
برای Claude Cowork و Claude Design صفحه اختصاصی مستقلی فعلاً روی سایت نداریم؛ اگه بهشون نیاز داری، بهتره اول از صفحه رسمی محصولات Anthropic تأییدشون کنی.
مدل جدید Claude: Fable 5.1 و Mythos 5.1
اول سپتامبر ۲۰۲۶، Anthropic این دو مدل رو معرفی کرد. طبق سیستم کارت رسمی، وزنهای مدل کاملاً یکسانه؛ تفاوت فقط در safeguardsه.
فرق Fable 5.1 با Mythos 5.1
| ویژگی | Claude Fable 5.1 | Claude Mythos 5.1 |
|---|---|---|
| مدل پایه | یکسان | یکسان |
| دسترسی | همه مشتریان API و پلنهای پولی claude.ai | فقط از طریق سه برنامه تأییدشده (پایین توضیح داده شده) |
| محدوده جغرافیایی | عمومی، طبق مناطق پشتیبانیشده Anthropic | عمدتاً سازمانهای آمریکایی، بهعلاوه حدود ۱۵۰ سازمان در ۱۵+ کشور از طریق Project Glasswing |
| امنیت سایبری | کشف آسیبپذیری آزاد؛ ساخت اکسپلویت به Opus 4.8 منتقل میشه | safeguards سایبری کاهشیافته برای مدافعان تأییدشده |
| علوم زیستی | سؤال عادی پزشکی آزاد؛ R&D به Opus 5 میره | safeguards تنظیمشده برای تحقیقات حرفهای |
| راه دسترسی | claude.ai، Claude API، AWS، Google Cloud، Microsoft Foundry | Cyber Verification Program (CVP)، Life Sciences Verification Program (LSVP)، Project Glasswing |
نکته فنی مهمی که در بیشتر مقالههای فارسی نیست: طبق System Card خود Anthropic، روی تسکهای سایبری، عملکرد Fable 5.1 تقریباً همسطح Opus 4.8 گزارش شده — یعنی نسخه Fable هیچ برتری واقعی توی کارهای امنیتی نسبت به Opus قدیمیتر نداره، چون فیلترها همیشه فعالن. برتری واقعی سایبری فقط توی Mythos 5.1 با safeguards خاموش دیده میشه، که در دسترس عموم نیست.

مشخصات فنی Fable 5.1
| مشخصه | مقدار |
|---|---|
| شناسه مدل در API | claude-fable-5-1 |
| پنجره کانتکست | ۱،۰۰۰،۰۰۰ توکن |
| حداکثر خروجی | ۱۲۸،۰۰۰ توکن (بدون پشتیبانی از batch خروجی ۳۰۰K مثل Opus 5) |
| تفکر (Thinking) | تطبیقی، همیشه فعال داخلی؛ قابل خاموش کردن نیست، ولی زنجیره خام فکر به کاربر نمایش داده نمیشود — فقط خلاصه یا بهروزرسانی پیشرفت در دسترسه |
| سطوح تلاش (effort) | چند سطح قابل تنظیم؛ سطح بالاتر = کیفیت و مصرف توکن بیشتر |
| ورودی/خروجی | متن و تصویر ← متن |
| تاریخ دانش | ژوئن ۲۰۲۶ (تازهترین بین مدلهای Claude) |
| سرعت | در طبقهبندی رسمی Anthropic «کندتر» از Opus 5 و Sonnet برچسب خورده؛ زمان واقعی به effort و تعداد فراخوانی ابزار هم بستگی داره |
| توکنایزر | همون توکنایزر معرفیشده با Opus 4.7؛ برای متن یکسان حدود ۳۰٪ توکن بیشتر از مدلهای قدیمیتر تولید میکنه |
| تاریخ انتشار | ۱ سپتامبر ۲۰۲۶ |
| بازنشستگی | طبق مستندات فعلی، زودتر از ۱ سپتامبر ۲۰۲۷ برنامهریزی نشده؛ این تعهد قبل از مهاجرت بلندمدت دوباره چک بشه |
| پلتفرمها | Claude API، Amazon Bedrock، Google Cloud، Microsoft Foundry، Claude Platform on AWS |
سه تغییر شکننده اصلی، طبق مستندات رسمی:
- forced tool use (
tool_choiceاز نوعanyیاtool) دیگه پشتیبانی نمیشه و خطای ۴۰۰ میگیری. - خوندن بلاکهای تفکر یکطرفهست: Fable 5.1 میتونه thinking blockهای مدلهای قبلی رو بخونه، ولی هیچ مدل قبلیای بلاکهای Fable 5.1 رو نمیخونه. اگه گفتگو از Fable 5.1 به مدل دیگه سوئیچ کنه، استدلال اون نوبتها از دست میره.
- تغییر پیشوند گفتگو، system prompt، ابزارها یا پیامهای قبلی میتونه بلاکهای تفکر رو نامعتبر کنه — بسته به شرایط، یا حذف میشن یا خطای ۴۰۰ میگیری. اگه integration شما تاریخچه پیامها رو بازنویسی میکنه، پیش از مهاجرت تستش کن.
رفتارهای جدیدی که کمتر جایی بهشون اشاره شده
مستندات رسمی چند تغییر رفتاری کوچیکتر رو هم اعلام کرده که روی تجربه واقعی اثر میذاره:
- فراخوانی موازی ابزارها متغیرتر شده؛ گاهی بهجای چند tool call در یک turn، فقط یکی میفرسته.
- توی effort پایین، کمتر سراغ جستوجو یا retrieval میره.
- هنگام ویرایش فایل، گاهی کل فایل رو از نو مینویسه بهجای patch جزئی.
- فرمتدهی (markdown، لیست) توی چت کمتر از Fable 5 استفاده میشه.

قیمت Claude و مدل Fable 5.1
| مورد | Fable 5.1 | Fable 5 | Opus 5 |
|---|---|---|---|
| ورودی | ۱۰ دلار / میلیون توکن | ۱۰ دلار | ۵ دلار |
| خروجی | ۵۰ دلار / میلیون توکن | ۵۰ دلار | ۲۵ دلار |
| نوشتن کش ۵ دقیقهای | ۱۲.۵۰ دلار | ۱۲.۵۰ دلار | ۶.۲۵ دلار |
| نوشتن کش ۱ ساعته | ۲۰ دلار | ۲۰ دلار | ۱۰ دلار |
| خواندن از کش | ۰.۲۵ دلار | ۱ دلار | ۰.۵۰ دلار |
| Batch (ورودی/خروجی) | ۵ / ۲۵ دلار | ۵ / ۲۵ دلار | ۲.۵۰ / ۱۲.۵۰ دلار |
نگهداری داده
Fable 5.1 و Mythos 5.1 بهصورت پیشفرض ۳۰ روز نگهداری داده دارن (برای مانیتورینگ ایمنی) و Zero Data Retention بهصورت عمومی در دسترس نیست — فقط با مجوز صریح Anthropic فعال میشه. اگه شرکتت روی ZDR حساب باز کرده، باید جداگانه تأییدیه بگیری.
Enterprise Frontier Safeguards (EFS) قراره از پاییز ۲۰۲۶ بهصورت مرحلهای عرضه بشه: داده فعالیت توی فضای ابری خود مشتری ذخیره میشه، با کلیدهای رمزنگاری خودش، و هشدارها مستقیم میره پیش مشتری بدون بازبینی انسانی از طرف Anthropic. تا اون موقع، فقط مشتریانی که Anthropic صراحتاً مجاز کرده میتونن ZDR بگیرن — این گزینه خودکار و عمومی برای همه حسابها نیست.
بنچمارکها و عملکرد

اعداد رسمی Anthropic
جدول زیر نتایج اعلامشده توسط خود Anthropicه؛ روش اجرا و تنظیمات در پاورقی رسمی هر بنچمارک اومده و باید با احتیاط خوند.
| بنچمارک | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 | ۵۲.۶٪ | ۲۴.۷٪ | ۲۹.۰٪ | ۲۲.۴٪ |
| Terminal-Bench 4.0 | ۵۵.۸٪ (۶۰.۹٪ با Mythos) | ۴۲.۰٪ | ۵۲.۳٪ | ۳۷.۳٪ |
| GDPval-AA v2 (Elo) | ۱،۸۵۳ | ۱،۷۲۳ | ۱،۸۲۴ | ۱،۷۱۱ |
| OSWorld 2.0 (partial) | ۷۷.۹٪ | ۷۲.۹٪ | ۷۵.۴٪ | — |
| OSWorld 2.0 (strict) | ۴۱.۷٪ | ۳۶.۱٪ | ۳۹.۶٪ | — |
| Humanity’s Last Exam (بدون/با ابزار) | ۶۰.۹٪ / ۶۵.۰٪ | ۵۷.۸٪ / ۶۳.۸٪ | ۵۶.۶٪ / ۶۳.۶٪ | — |
| AutomationBench | ۳۱.۴٪ | ۱۷.۱٪ | ۲۶.۹٪ | ۱۹.۶٪ |
| CursorBench 3.2.0 | ۷۳.۴٪ | ۷۰.۵٪ | ۷۰.۰٪ | ۶۷.۲٪ |
خطای معیار Terminal-Bench-Science حدود ۳.۵ تا ۴.۵ واحده — اختلافهای کوچیک معنادار نیستن. نمرات OSWorld روی نسخه جدید تسکهاست و با نتایج قبلی قابل مقایسه نیست. Fable با فیلترهای فعال تست شده که طبق اعلام خود Anthropic احتمالاً نمرهش رو پایین آورده (روی چند تسک OSWorld و AutomationBench که فیلتر فعال شده، نمره صفر ثبت شده).
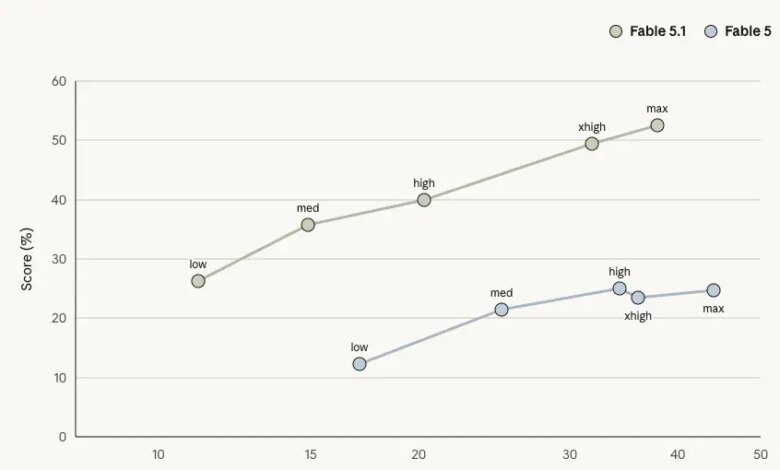
در همون snapshot ارزیابی که این شرکت منتشر کرد، Fable 5.1 با effort سطح max نمره ۶۶ گرفت — بالاترین عددی که تا اون لحظه در شاخص این شرکت ثبت شده بود، جلوتر از Opus 5 (۶۳) و Fable 5 (۶۲). این نمره مربوط به عملکرد یک سیستم با routing و fallback فعاله، نه یک مدل کاملاً مجزا.
همون ارزیابی، هزینه هر تسک رو حدود ۳.۷۶ دلار برآورد کرد — در برابر ۳.۱۴ دلار برای Fable 5، یعنی حدود ۲۰٪ گرونتر. علتش: Fable 5.1 در این workload خاص حدود ۱.۷ برابر Fable 5 توکن خروجی تولید کرده؛ این نسبت مال همون تنظیم max است و نباید به همه کاربردهای Claude Code یا API تعمیم داده بشه. پنج سطح effort این مدل بازهای ۱۱ برابری توی مصرف توکن دارن (۱۳.۱ تا ۱۴۳.۷ میلیون توکن).
نظر کاربران و جامعههای فنی
نظرات زیر از بحثهای Hacker News، Reddit و X جمعآوری و خلاصه شدن. این نمونه، نماینده آماری کل کاربران Claude نیست؛ فقط تصویری از واکنش جامعه فعال و علاقهمند به این حوزهست.
Hacker News: بحث داغ سبک نوشتاری
بزرگترین رشته بحث زیر پست معرفی، درباره نحوه حرف زدن مدل بود. کاربری با نام کاربری felixrieseberg که خودش را کارمند Anthropic معرفی میکند، نوشت مهمترین پیشرفت Fable 5.1 از نظرش فراتر از بنچمارکهاست: سبک نوشتنش طبیعیتر شده و دو برابر شدن نمره Terminal-Bench-Science رو نشانه معناداری برای آینده علم دونست.
پاسخها تلختر بود. کاربری با نام niccl نوشت با اینکه انگلیسی زبان مادریشه و زیاد مطالعه میکنه، وقتی با خروجی یه جلسه طولانی روبهرو میشه واقعاً نمیفهمه مدل چی میگه. کاربر astro1234 نوشت شغلش از کدنویسی تبدیل شده به حل معمای اینکه مدل چی داره میگه، و سطح خستگیاش هیچوقت اینقدر بالا نبوده، با اینکه مدلها عملاً بهتر شدن.
راهحلهای عملی که چند کاربر به اشتراک گذاشتن: GrinningFool گفت مؤثرترین دستوری که پیدا کرده اینه: «از صفتهای برترین استفاده نکن، سبک اقناعی به کار نبر». jaapz خروجی پرحرف رو به یه ایجنت Haiku میده تا خلاصهش کنه. ninjalanternshk گفت بعد از اینکه به Claude گفته این سبک رو کنار بذاره، پاسخها شاید ۲۰٪ طولانیتر شدن ولی حداقل دو برابر سریعتر خونده میشن.
ردیت: طنز، مصرف توکن و محدودیت اشتراک
توی سابردیتهای r/ClaudeAI و r/ClaudeCode سه تم اصلی دیده میشه: طنز درباره سبک حرف زدن مدل (یه پست پرطرفدار با عنوان «پاسخ متوسط Opus 5» به مرجع مشترک کاربران تبدیل شد)؛ نگرانی از اینکه تخفیف کشخوانی توی API اتفاق افتاده ولی سقف اشتراکهای ماهانه عوض نشده؛ و اعتراض بعضی کاربران به واترمارک نامرئی.
X و کاربران حرفهای: تحسین گسترده، با یک استثنای اصلی
تحلیلگر مستقل Zvi Mowshowitz دهها واکنش جمعآوری کرد. جمعبندیاش: بهجز موضوع مصرف توکن، Fable 5.1 بازخورد عمدتاً مثبتی گرفته. کاربری با نام کاربری Dan Shipper که مدیرعامل شرکت Every معرفی میشود، نوشت هوش سطح Fable، قیمت سطح Opus، سرعت سطح Sonnet — تیمش گزارش داد حدود دو برابر سریعتر از Opus 5 بوده و تقریباً نصف توکن مصرف کرده.
در مقابل، کاربری با نام David Case نوشت اگه آزادش بذاری سه برابر نسخه قبلی توکن میسوزونه؛ یه کار دو ساعته ۲۰٪ از سهمیه هفتگیاش رو برد. کاربر Sean McCarthy نوشت اولین باره که با اشتراک پنجبرابریاش احساس محدودیت کرده. کاربر Siméon صریحترین انتقاد رو داشت: مدل برای خود اقدامگرایی عاشق اقدام کردنه، چه مفید باشه چه نباشه. جالبه که چند نفر — از جمله همون تحلیلگر مستقل — این مدل رو با GPT-6 Astra هم مقایسه کردن و گفتن فاصله بین این دو رقیب خیلی کمتر از قبل شده.
جمعبندی نظرات جامعه
در نمونهای که بررسی کردیم، گرایش غالب مثبت بود، اما این یک اجماع آماری نیست. تحسینها بیشتر حول کدنویسی و بهبود نوشتار بود؛ انتقادها بیشتر به مصرف توکن، محدودیت اشتراک و سبک نوشتار مربوط میشد. یه الگوی مشترک هم دیده میشه: چند کاربر مستقلاً به «استفاده ترکیبی» رسیدن — یه مدل برای طراحی و تحلیل، یکی برای اجرا.
نتایج علمی
طراحی پروتئین
Anthropic میگوید روی سه هدف مشخص از رقابتهای Adaptyv Bio، برخی پروتئینهای طراحیشده با Mythos 5.1 عملکرد بهتری نسبت به بهترین نمونههای مقایسهشده داشتند و میل اتصالشون تا ده برابر بالاتر بود. نرخ موفقیت روی دوازده هدف به نزدیک ۵۰٪ رسید (در برابر نرخ معمول ۱۰-۱۵٪ این حوزه). این نتیجه محدود به همون اهداف و طراحی آزمایشه و نباید به «برتری مطلق در طراحی دارو» تعمیم داده بشه. طراحیها برای اعتبارسنجی به دو سازمان بیرونی فرستاده شدن؛ این با یه مطالعه مستقل و تکرارشده یکی نیست.
نقشهبرداری سیاره زهره
Fable 5.1 یه شبکه عصبی آموزش داد که نقشه ارتفاعی جدیدی از یکسوم زهره بسازه، بر اساس تصاویر رادار مأموریت مگلان ناسا. وضوح مکانی از ۱۰-۲۰ کیلومتر به ۲-۳ کیلومتر رسید؛ Anthropic ادعا میکنه دقت ارتفاع هم تا ۲۵٪ بهتر شده — این دو عدد (وضوح و دقت) دو معیار جدا هستن. نقشه با لایسنس Creative Commons منتشر شد.
بهینهسازی GPU
Anthropic میگوید Mythos 5.1 با نوشتن کرنلهای سفارشی، هفت مدل یادگیری عمیق متنباز رو بین ۱.۴ تا ۲.۵ برابر سریعتر کرد، با خروجی مطابق مدلهای اصلی. روی تحلیلهای سراسر-ژنوم، هزینه GPU ۳۰ تا ۶۰ درصد کم شد. Anthropic میگوید این کار معمولاً برای یک تیم مهندسی هفتهها زمان میبرد.
ایمنی، فیلترها و حریم خصوصی
فیلترها دقیقتر شدن، نه شلتر
- امنیت سایبری: کاربران Claude Code حدود ۶۰٪ دخالت کمتر در هر نشست تجربه میکنن. کشف آسیبپذیری روی Fable 5.1 آزاده، ولی ساخت اکسپلویت همچنان به Opus 4.8 منتقل میشه.
- زیستشناسی: فیلترهای جدید ۸۵٪ کمتر روی سؤالات ساده پزشکی فعال میشن؛ R&D علوم زیستی هنوز به Opus 5 میره.
ارزیابی ریسک — با قید «طبق ادعای Anthropic»
طبق گزارش خود Anthropic، Mythos 5.1 در حالتی که safeguards مربوط به سنجش توانایی خاموش بود قویترین توانایی سایبری بین مدلهای این شرکت رو نشون داده — این با محصولی که کاربران واقعی دریافت میکنن یکی نیست. برای آزمون استحکام safeguards، Anthropic میگوید از دو سازمان بیرونی سفارش تست داده و شرکت Gray Swan هم آزمون خودکار انجام داده؛ نتیجه این بود که «هیچ jailbreak با شدت بحرانی پیدا نشد» — این یک گزارش خوداظهاری از طرف شرکته، نه یک ممیزی کاملاً مستقل.
همراستایی و حوادث جولای
ممیزی رفتاری خودکار Anthropic نشون داد Mythos 5.1 توی اکثر معیارها بهتر از نسل قبل همراستاست: کمتر تلاش میکنه به منابع بیرون از محیط تستش دسترسی پیدا کنه و نرخ تقلب برای پاداش پایینتر اومده. با این حال Anthropic اعلام کرد مدل هنوز گاهی میتونه از تأییدیهها عبور کنه، و پوشش ممیزی برای کارهای با کانتکست خیلی طولانی محدوده.
در گزارش EFS، Anthropic به سه حادثه در ژوئیه ۲۰۲۶ اشاره کرده که در آنها «مدلهای Claude» به سیستمهای واقعی دسترسی غیرمجاز پیدا کردن. این گزارش بهتنهایی ثابت نمیکنه که Fable 5.1 یا Mythos 5.1 مشخصاً در این حوادث دخیل بودن — عبارت رسمی گستردهتر از این دو مدله.
واترمارک و قانون اتحادیه اروپا
برای پسزمینه کاملتر این موضوع، مقاله اختصاصی واترمارک نامرئی Claude رو ببین. خلاصهش: از ۲ آگوست ۲۰۲۶، خروجی متنی مدلهای جدید Claude یک واترمارک آماری داره که طبق ادعای Anthropic هیچ اطلاعاتی از کاربر، سازمان یا مکالمه حمل نمیکنه. این واترمارک فقط شامل متنه؛ فایلهای چندرسانهای تولیدشده در مسیرهای پشتیبانیشده ممکنه بهجاش credential های C2PA داشته باشن — این دو مکانیزم متفاوتن.
کِی از Fable 5.1 استفاده کنیم و کِی نه
خود مستندات Anthropic توصیه میکنه برای اکثر کارها از Opus 5 شروع کنی و فقط وقتی سراغ Fable 5.1 بری که evalهات روی Opus 5 با effort بالا هم جواب نداده. برای مقایسه سیستماتیکتر مدلها، راهنمای کامل انتخاب مدل مناسب ما رو هم ببین.
کجا میدرخشه
Fable 5.1 وقتی ارزش پولش رو داره که کارت اینها رو داشته باشه: مراحل زیاد، کدبیس یا مجموعه اسناد بزرگ، استفاده جدی از ابزار، نیاز به بررسی تکراری، و یه آدم که خروجی رو بازبینی کنه. مثال: بررسی یه کرش نادر، مهاجرت اپلیکیشن بزرگ، بازبینی قرارداد یا صورت مالی طولانی، ریشهیابی حادثه پروداکشن.
کجا اشتباهه
- کارهایی که مدل کوچیکتر خوب انجام میده.
- کارهای پرریسک بدون بازبینی انسانی.
- سؤال درباره اتفاقات روز، بدون ابزار جستجو.
- هر چیزی که دسترسی نامحدود به پروداکشن میخواد.
- مشاوره پزشکی، حقوقی یا مالی بدون بازبینی متخصص.
چیزی که هنوز نمیدانیم
- عملکرد واقعی روی بار کاری متنوع و مستقل هنوز محدوده؛ اکثر دادهها یا از خود Anthropic یا از یک snapshot ارزیابی میان.
- ادعاهای علمی (پروتئین، زهره، GPU) عمدتاً از طرف Anthropic گزارش شدن، نه توسط یه مرجع کاملاً مستقل تکرار شدن.
- اثر دقیق Fable 5.1 روی سقف اشتراکهای claude.ai (نه API) هنوز بهطور رسمی جایی مستند نشده.
- هزینه واقعی هر تسک به effort، prompt caching، تعداد فراخوانی ابزار و fallback بستگی داره و از کاربری به کاربری فرق میکنه.
جمعبندی
Fable 5.1 قدم واقعی جلو رفته، مخصوصاً توی تحقیق علمی ایجنتی و کدنویسی بلندمدت. ولی داستان جالبتر توی جدول بنچمارک نیست: Anthropic کنار ارتقای توانایی، سه تغییر ساختاری هم آورده — safeguards دقیقتر، معماری داده تحتمالکیت مشتری (EFS)، و ضدتقطیر قویتر.
و نکتهای که جامعه کاربران بلند گفته: این مدل پرحرف و پرمصرفه. اگه با اشتراک کار میکنی، effort رو آگاهانه انتخاب کن؛ اگه با API کار میکنی، روی بار کاری خودت اندازه بگیر — نه روی ادعای هیچکس، نه Anthropic و نه کاربران X.
